مؤشر الظهور في الذكاء الاصطناعي: ماذا يقيس وكيف تقرأ نتيجتك
مؤشر الظهور في الذكاء الاصطناعي رقم واحد من 100. وهو يقدّر مدى جاهزية الموقع لأن تجده محركات الإجابة بالذكاء الاصطناعي، مثل ChatGPT وGemini وPerplexity وGoogle AI Overviews، وتقرأه وتذكره. وليس ترتيبًا للكلمات المفتاحية ولا رقمًا للزيارات. بل يقيس الجاهزية: هل الإشارات التقنية والتحريرية التي يعتمد عليها النموذج موجودة فعلًا في موقعك قبل أن يقرر إدراج علامتك في إجابة.
لقد بنينا واحدًا وجعلناه علنيًا. فمؤشر الظهور في الذكاء الاصطناعي من VOCTOS يُجري 45 فحصًا على موقع حي، ويعرض الرقم دون أن يطلب بريدًا إلكترونيًا أولًا، ويرفق الدليل وراء كل نتيجة.
ويشرح هذا المقال ما يفحصه، وكيف تعمل الأوزان، وكيف تقرأ النتيجة، وبالأهمية نفسها، ما لا يستطيع الرقم إخبارك به.
نوزن المجموعات بهذه الطريقة لأننا رأيناها تتحرك في مواقع حية. فلدى مختبرات دلتا الطبية 5,570 صفحة مستشهدًا بها في محركات الذكاء الاصطناعي حتى يوليو 2026، موزعة بين 3,600 في AI Overviews و1,800 في AI Mode و130 في ChatGPT و40 في Gemini، على موقع تجاوزنا به مليون زيارة عضوية شهريًا منذ مارس 2026.
ولدى إيسال 753 صفحة مستشهدًا بها في الذكاء الاصطناعي خلال اثني عشر شهرًا بمتوسط ترتيب 5.5 في Google. ولم يأتِ أي من الرقمين من أداة تقييم، بل جاء كلاهما من تنفيذ العمل بالترتيب الذي تضع فيه هذه الدرجة الفحوصات. وما لا نستطيع تقديمه هو مقارنة مضبوطة. فلم نعمل قط مع عميل دون إصلاح وصول الزواحف أولًا، لذا فترتيبنا حكم مدروس لا نتيجة مقيسة.
الجاهزية ليست الحضور
هذا هو التمييز الذي نراه يُتجاوز في معظم النقاشات حول الظهور في الذكاء الاصطناعي، والخطأ فيه يهدر الميزانية. فالحضور هو ما إذا كان محرك يذكرك اليوم، ويتحرك من أسبوع لآخر. والجاهزية هي ما إذا كانت شروط ذكرك موجودة أصلًا، وهي الجزء الذي تتحكم فيه.
الحضور هو ما إذا كان محرك يذكرك اليوم، حين يطرح مشترٍ سؤالًا حقيقيًا.
وهو يتحرك من أسبوع لآخر، ويختلف حسب المحرك، ويعتمد على أمور خارج موقعك: من نشر غيرك، وما الذي فُهرس، وأي المصادر صادف أن استرجعها النموذج.
الجاهزية هي ما إذا كانت شروط ذكرك موجودة أصلًا. فإذا لم يستطع الزاحف الوصول إلى صفحاتك، وإذا كانت حقائق نشاطك ملتبسة، وإذا لم يكن في الموقع شيء على شكل إجابة، فلن يفيد أي حجم من النشر.
والجاهزية هي الجزء الذي تتحكم فيه بالكامل، وفي تعاقداتنا هي الجزء الذي نصلحه أولًا.
ويقيس مؤشر الظهور في الذكاء الاصطناعي الجاهزية. ويذكر التقرير ذلك صراحةً بدلًا من الخلط بين الاثنين، وهذا مهم لأن الدرجة المبنية على مزيج منهما درجة لا تستطيع العمل بناءً عليها.
وحين تُضمَّن طبقة المحركات الحية، يُبلغ عنها إلى جانب الرقم الخاص بالموقع، ولا تُدمج فيه أبدًا. فلا يجوز أن يؤدي خلل في الشبكة لدى محرك إلى رفع درجتك أو خفضها بصمت.
مجموعات الإشارات الأربع، ولماذا تختلف أوزانها
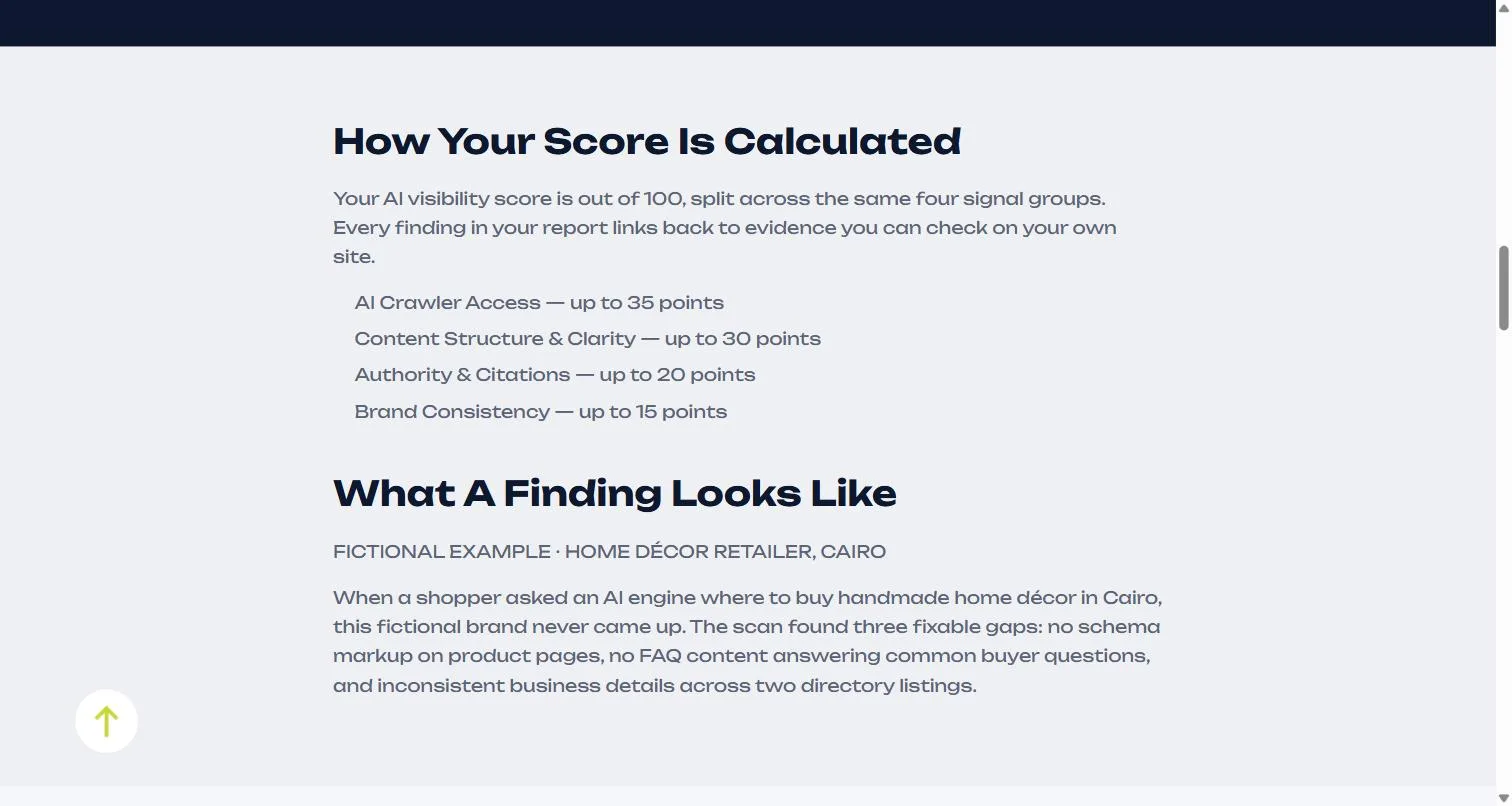
كل عملية فحص تتضمن 45 فحصًا فرديًا، مجمّعة في أربع عائلات. ولا تحمل المجموعات وزنًا متساويًا، لأنها لا تحمل عواقب متساوية. فوصول زواحف الذكاء الاصطناعي يحمل 35 نقطة، وبنية المحتوى ووضوحه 30، والسلطة والاستشهادات 20، واتساق العلامة 15.
35 نقطة وصول زواحف الذكاء الاصطناعي. هل يستطيع GPTBot وPerplexityBot وGoogle-Extended وغيرها من وكلاء الذكاء الاصطناعي الوصول إلى صفحاتك وقراءتها فعليًا.
30 نقطة بنية المحتوى ووضوحه. العناوين وترميز البيانات المهيكلة (Schema) ومدى إجابة صفحاتك مباشرةً عن سؤال مشترٍ حقيقي.
20 نقطة السلطة والاستشهادات. الإشارات والمراجعات والمصادر الخارجية التي يستطيع المحرك استخدامها للتحقق من أنك حقيقي.
15 نقطة اتساق العلامة. هل يقول اسمك وفئتك وحقائق نشاطك الشيء نفسه في كل مكان.
ونمنح وصول الزواحف الحصة الأكبر لسبب بسيط: فهو ثنائي، ويسبق كل شيء آخر، ولا تستطيع أي مجموعة أخرى تعويضه.
فوكيل مستخدم محظور في robots.txt، أو صفحة لا تُعرض إلا بعد JavaScript، أو قاعدة جدار حماية تُرجع تحديًا لحركة غير المتصفحات، تجعل الفحوصات الـ44 الأخرى بلا قيمة. وقد كتبنا عن تفاصيل ذلك في دليلنا حول قواعد robots.txt لزواحف الذكاء الاصطناعي.
ووضعنا اتساق العلامة أخيرًا، بـ15 نقطة، لا لأنه غير مهم، بل لأنه في تجربتنا الأبطأ حركةً.
فهو يعتمد على ملفات وقوائم خارجية لا تتحكم فيها بالكامل.
كيف يعمل الفحص
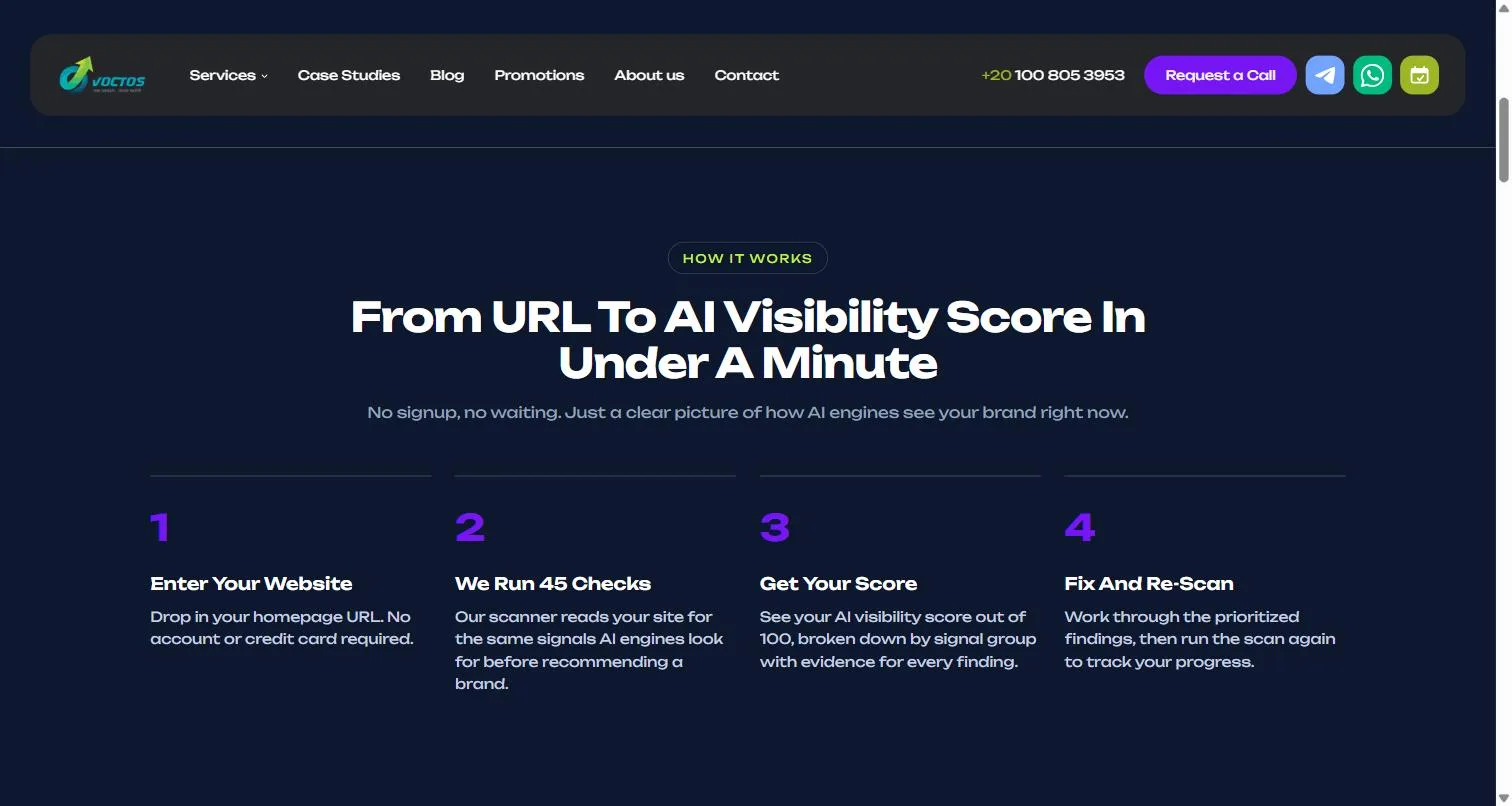
أربع خطوات، دون إنشاء حساب ولا بطاقة دفع، في أقل من دقيقة. نقرأ صفحتك الرئيسية ونعرض عليك ما نعتقد أنك تبيعه، فتصححه، وتختار سوقك الرئيسية. ويصبح هذان المدخلان أسئلة المشترين التي يُجرى الفحص عليها فعلًا.
الخطوة الثانية هي المهمة
معظم أدوات الفحص المجانية تقيّم الرابط بمعزل عن غيره. وهذا ينتج رقمًا صحيحًا تقنيًا لا يخبرك بشيء عن الواقع التجاري، لأن الظهور في الذكاء الاصطناعي يعتمد على السؤال.
فأنت لست ظاهرًا أو غير ظاهر على وجه العموم، بل ظاهر أو غير ظاهر لسؤال محدد، يُطرح في سوق محدد.
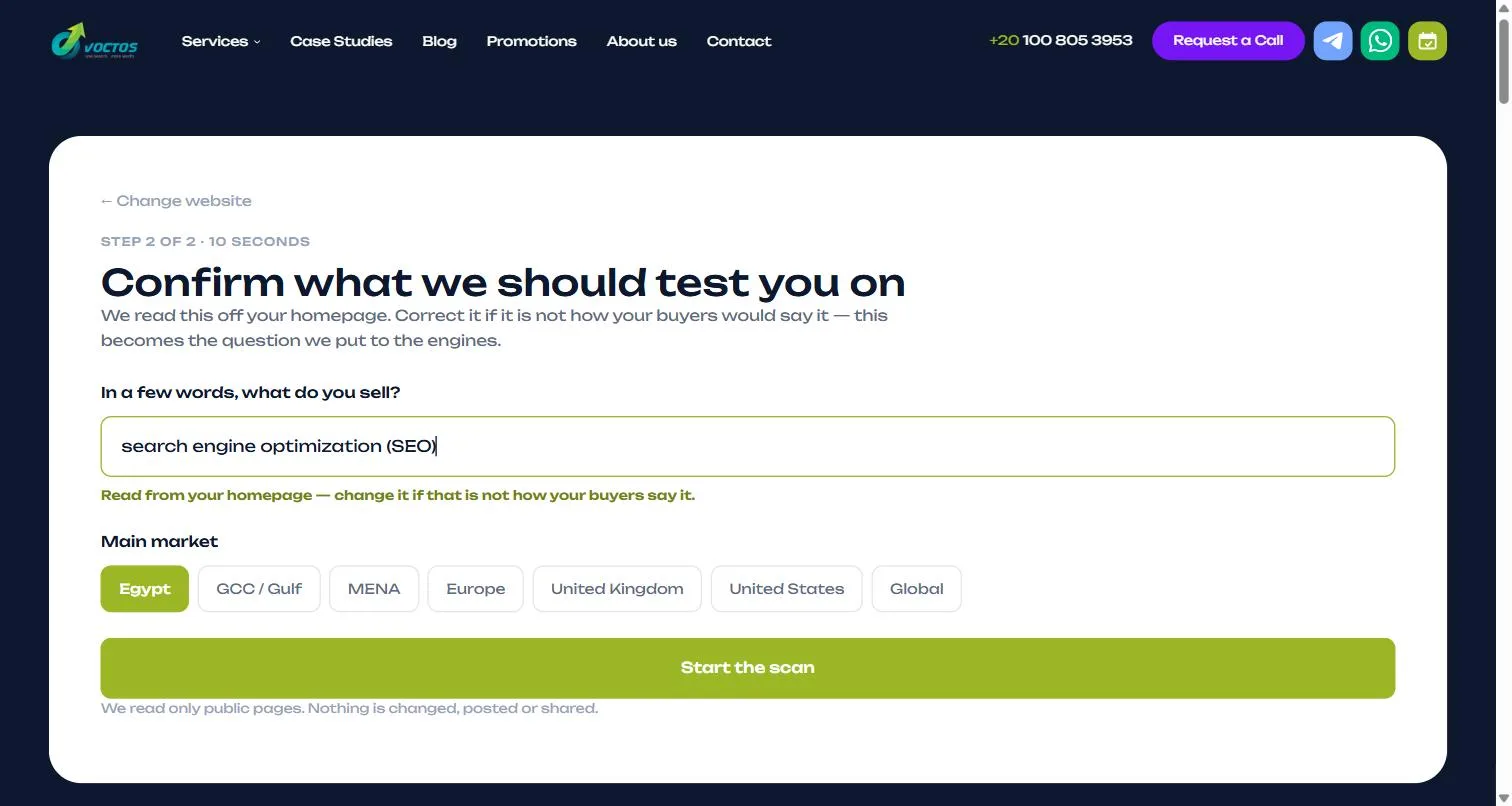
لذا قبل أن يبدأ الفحص، نقرأ صفحتك الرئيسية، ونستخرج ما يبدو أنك تبيعه، ونعرضه عليك للتصحيح.
ثم تختار سوقك الرئيسية. ويصبح هذان المدخلان أسئلة المشترين التي نختبرها.
الأسئلة ليست سلاسل كلمات مفتاحية. فهي مصاغة بالطريقة التي يكتبها المشتري فعلًا في نافذة المحادثة، وتغطي ثلاث نوايا مختلفة:
- قائمة مختصرة تجارية. “ما أفضل [الفئة] في [السوق]؟ أعطني قائمة قصيرة مرتبة مع سبب من سطر واحد لكل منها.”
- توصية موجّهة. “أحتاج إلى مساعدة في إيجاد شركة موثوقة في [الفئة]. أي الشركات في [السوق] توصي بها فعلًا، ولماذا؟”
- مقارنة تنافسية. “قارن بين أفضل الخيارات في [الفئة] في [السوق]. من هم اللاعبون الرئيسيون وكيف يختلفون في السعر والجودة والموثوقية؟”
وهذه الصياغات الثلاث تستخرج إجابات مختلفة من النموذج نفسه، وهذا بالضبط المقصود.
فقد تظهر العلامة في القائمة المختصرة وتختفي من المقارنة. واختبار أمر واحد وتسميته ظهورًا هو ما يجعل الفرق واثقة ومخطئة في آن.
لا يقرأ الفحص إلا الصفحات العامة، ولا يغيّر أو ينشر أو يشارك أي شيء.
من أين تأتي الدرجة: منظور الركائز
تُجمَّع فحوصاتنا الـ45 في ركائز مرجّحة، وهذا هو المنظور الذي نريدك أن تعمل منه. فالإجمالي يخبرك بحالك، ودرجات الركائز الأربع تخبرك بأي مجموعة تكلّفك أكثر النقاط، وهو الجزء الوحيد من التقرير الذي يتحرك هذا الأسبوع.
الرقم المركّب يخبرك بحالك. وتفصيل الركائز يخبرك بما تفعله يوم الاثنين.
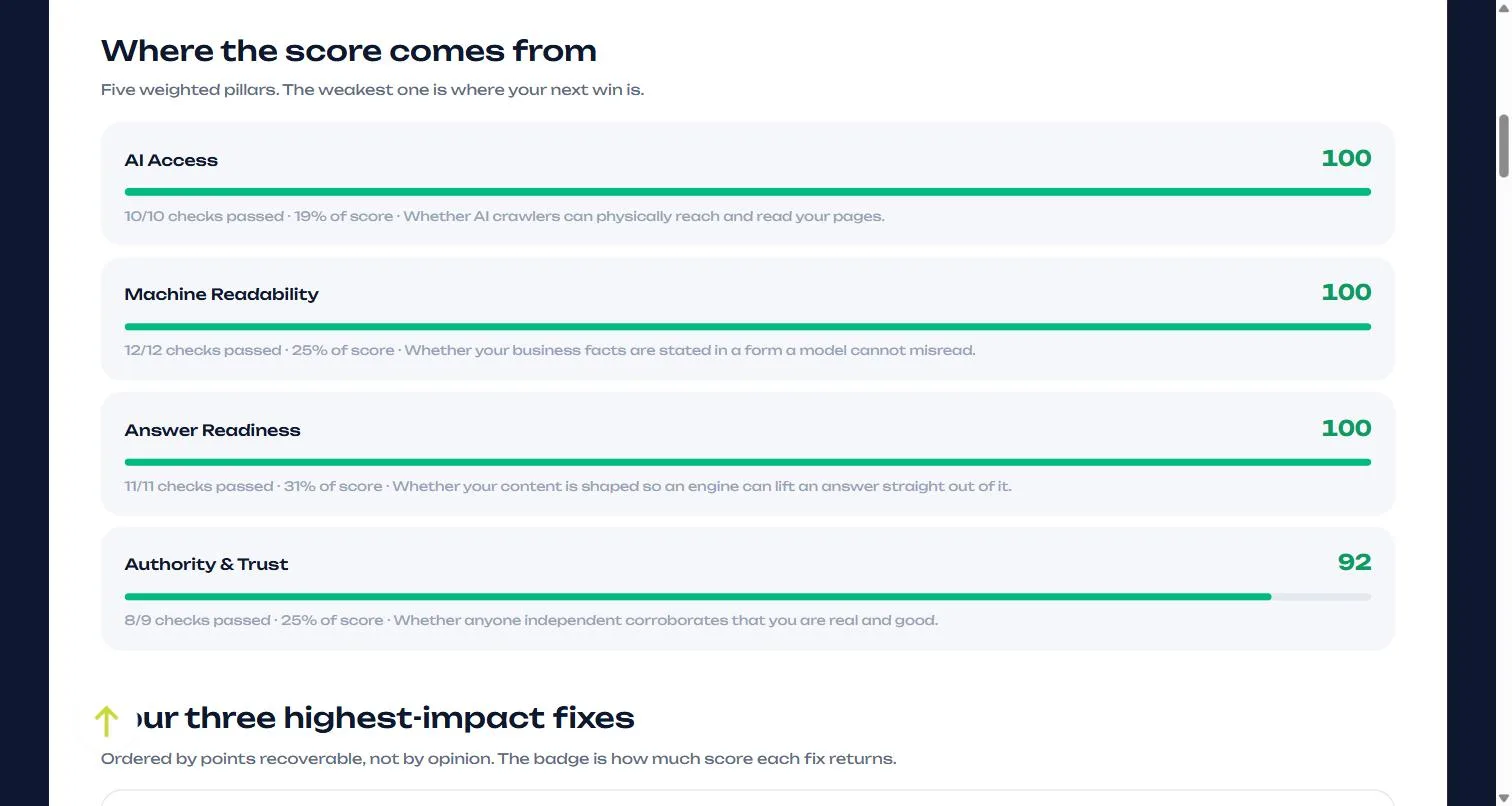
- وصول زواحف الذكاء الاصطناعي، 12 فحصًا، 35 من 100 نقطة. هل يستطيع GPTBot وPerplexityBot وGoogle-Extended وغيرها من وكلاء الذكاء الاصطناعي الوصول إلى الصفحات وقراءتها فعليًا.
- بنية المحتوى ووضوحه، 15 فحصًا، 30 نقطة. هل تذكر العناوين والبيانات المهيكلة وبنية الصفحة حقائق النشاط بصيغة لا يستطيع النموذج إساءة قراءتها.
- السلطة والاستشهادات، 10 فحوصات، 20 نقطة. هل يؤكد أي طرف مستقل أن النشاط حقيقي ويستحق الذكر.
- اتساق العلامة، 8 فحوصات، 15 نقطة. هل يقول الاسم والفئة وحقائق النشاط الشيء نفسه في كل دليل يقرؤه المحرك.
يحمل الوصول الوزن الأثقل بـ35 نقطة، وتأتي البنية خلفه مباشرة بـ30. والترتيب أهم من الفارق. فالنموذج لا يرتّب صفحتك ويعطي المستخدم رابطًا.
بل يقتطع فقرة، ما يعني أن الصفحة التي لا تحمل إجابة مستقلة قابلة للاقتباس لن يُقتبس منها أبدًا مهما كان ترميزها نظيفًا. لكنها لن تُقرأ أصلًا إذا كان PerplexityBot محظورًا في السطر الرابع عشر من robots.txt لديك. فالوصول أولًا والبنية بعده مباشرة، وهذا هو السبب الكامل لوقوف المجموعتين عند خمس وثلاثين وثلاثين بدلًا من التساوي. وهذه هي الآلية وراء نصيحتنا حول كتابة كبسولات الإجابة.
وإلى جانب هذه الأربع توجد قراءة للحضور الفعلي، مأخوذة من أسئلة المشترين أعلاه.
ويُبلغ عنها بجوار ركائز الموقع لا مدمجةً فيها، ليبقى الجزء الذي يمكنك إصلاحه ظاهرًا بجوار الجزء الذي يمثل إجابة السوق الحالية.
كيف تبدو النتيجة فعلًا
الدرجة دون دليل رأي مرفق برقم. فكل نتيجة في التقرير تتبع البنية نفسها من ثلاثة أسطر، وتحمل النقاط التي تستعيدها إذا أصلحتها: ما وجدناه، ولماذا يهم، وتعليمة واحدة يستطيع مطوّر أو محرر تنفيذها.
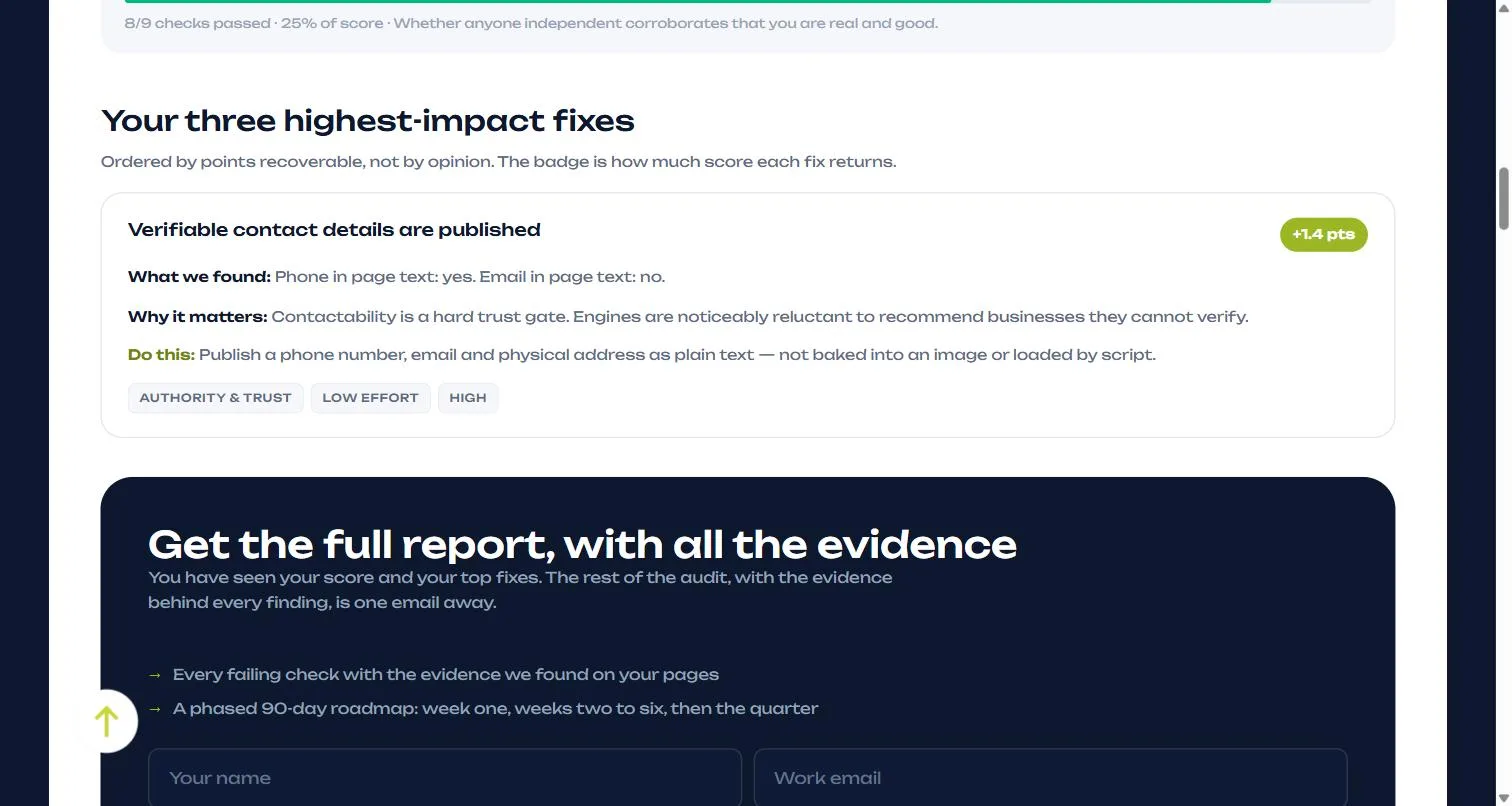
- ما وجدناه. الحالة المرصودة بعبارات بسيطة. “الهاتف في نص الصفحة: نعم. البريد الإلكتروني في نص الصفحة: لا.”
- لماذا يهم. الآلية لا عبارة مكررة. فإمكانية التواصل بوابة ثقة صارمة، والمحركات مترددة بوضوح في التوصية بنشاط لا تستطيع التحقق منه.
- افعل هذا. تعليمة واحدة يستطيع مطوّر أو محرر تنفيذها دون اجتماع متابعة.
وكل نتيجة موسومة بركيزتها وتقدير للجهد وتقييم للأثر، وأهم الإصلاحات مرتبة حسب النقاط القابلة للاسترداد لا حسب الرأي.
ورتّبناها بهذه الطريقة عن قصد، فهذا يمنع تقريرنا من أن يصبح قائمة أمنيات ويحوّله إلى قائمة عمل.
كيف تقرأ رقمك
ثلاث حالات عامة، وما يجب أن تستدعيه كل منها. فالدرجة المنخفضة المتركزة في الوصول للذكاء الاصطناعي مشكلة بنية تحتية، فأوقف كل شيء آخر. والدرجة المتوسطة الموزعة بالتساوي على الركائز تعني تنفيذ قائمة العمل بترتيب النقاط. والدرجة المرتفعة مع حضور فعلي ضعيف تعني أن القيد غادر موقعك.
درجة منخفضة مع إخفاقات متركزة في الوصول للذكاء الاصطناعي. أوقف كل شيء آخر.
لديك مشكلة بنية تحتية لا مشكلة محتوى، وكل ساعة تقضيها في الكتابة قبل إصلاحها ساعة تنشر فيها في غرفة لا يستطيع أحد دخولها. وعادةً ما يكون هذا إصلاحًا في الأسبوع نفسه يتولاه مطوّر واحد.
درجة متوسطة موزعة بالتساوي على الركائز. هذه هي النتيجة الأشيع والأقل إثارة. لا شيء معطّل، ولا شيء قوي. نفّذ قائمة العمل بترتيب النقاط.
وفي موقع يجتاز بالفعل فحص وصول الزواحف، نتوقع أن تأتي الحركة من بنية المحتوى ووضوحه. فبـ30 نقطة، هي أكبر مجموعة لا يزال بإمكانك تحريكها من داخل نظام إدارة المحتوى لديك.
درجة مرتفعة مع حضور فعلي ضعيف. وهي الحالة الأكثر إثارة، والتي تفصل الجاهزية عن الحضور. فموقعك جاهز للاستشهاد به ولا يزال لا يُستشهد به.
عند هذه النقطة يكون القيد قد انتقل من نطاقك إلى الويب الأوسع: التغطية الخارجية ومنصات المراجعات وذكر المجتمعات والمصادر التي تسترجع منها المحركات فعلًا. وهذه مشكلة علاقات عامة رقمية، ولن يحلها أي قدر من العمل داخل الصفحة.
موقفنا من هذا
نحن من بنى أداة التقييم، لذا تعامل مع الإطار بوصفه حجة لا معيارًا محايدًا. وما سندافع عنه هو المنهجية: وزن الفحوصات حسب العواقب، وإرفاق دليل بكل نتيجة، وترتيب الإصلاحات حسب النقاط القابلة للاسترداد، والفصل بين الجاهزية والحضور. فإذا استخدمت أداة مختلفة تفعل هذه الأمور الأربعة، فستصل إلى الاستنتاجات نفسها تقريبًا.
ما لا تخبرك به الدرجة
نعتقد أن الوضوح بشأن الحدود هو ما يجعل رقمنا مفيدًا. فالدرجة ليست توقعًا، ودرجة 90 لا تعد بالاستشهادات، بل تزيل أسباب الاستبعاد فقط. وهي قراءة في لحظة زمنية، لأن المحركات تغيّر سلوك الاسترجاع والمنافسين يواصلون النشر.
- ليست توقعًا. درجة 90 لا تعد بالاستشهادات، بل تزيل أسباب الاستبعاد.
- إنها قراءة في لحظة زمنية. فالمحركات تغيّر سلوك الاسترجاع، والمنافسون ينشرون، والقوائم تتغير. والفحص الواحد صورة لا اتجاه. أعد الفحص بعد تنفيذ الإصلاحات، ثم وفق جدول.
- لا تعرف سياقك التجاري. الأداة ترى موقعًا، ولا ترى الهوامش ولا دورة المبيعات ولا ما إذا كان السؤال الذي تحسّن له يتحول إلى مبيعات أصلًا.
- لا تستطيع قياس الطلب على العلامة. فإذا لم يكتب أحد خارج موقعك عنك قط، فسقف السلطة والاستشهادات هيكلي، ويُصلح خارج الموقع على مدى أشهر.
وإذا أردت الحجة الأوسع حول ما يقيسه هذا النوع من الأدوات جيدًا وما يغفله، فقد عرضناها في أدوات الظهور في الذكاء الاصطناعي: ما تقيسه وما تغفله.
والدرجة هي الركيزة الرابعة في طريقة عملنا.
أما الثلاث الأخرى، سلطة الكيان والاستشهادات المهندسة والمخطط القابل للقراءة آليًا، فمعروضة في منهجية VOCTOS، إلى جانب تحليل فجوات الأوامر الذي يبدأ به كل تعاقد.
ماذا يحدث بعد الدرجة
يمنحك الفحص العلني الرقم وتفصيل الركائز وأهم الإصلاحات، على الصفحة، مجانًا. وكل ما بعد ذلك إما التقرير الكامل المرسل بالبريد أو العمل نفسه، والنسخة المجانية قائمة بذاتها دون محادثة معنا.
ويضيف التقرير الكامل المرسل بالبريد الإلكتروني أمرين لا يستطيعهما العرض داخل الصفحة: كل فحص فاشل مع الدليل الذي وجدناه في صفحاتك، وخارطة طريق مرحلية لـ90 يومًا مقسّمة إلى الأسبوع الأول، والأسابيع من الثاني إلى السادس، وبقية الربع.
أما العملاء ذوو العقود المستمرة فيجري القياس نفسه لهم باستمرار داخل بوابة عملاء VOCTOS بدلًا من فحص لمرة واحدة، ويُتتبع بجوار الاستشهادات وحركة المنافسين والعمل الذي يُنفذ فعلًا.
فتصبح الدرجة خطًا في رسم بياني بدلًا من لقطة، وهذه هي الطريقة الوحيدة للتمييز بين الإصلاح والتذبذب.
الأسئلة الشائعة
ما الدرجة الجيدة في مؤشر الظهور في الذكاء الاصطناعي؟
الدرجة التي تتجاوز 85 تعني أن شروط الاستشهاد داخل الموقع متوفرة وأن قيدك المتبقي يقع، بشبه يقين، خارج الموقع. والدرجة بين 60 و85 تعني أن هناك أرضًا حقيقية قابلة للاسترداد في نطاقك.
والدرجة الأقل من 60 تشير عادةً إلى أمر هيكلي، غالبًا مشكلة في وصول الزواحف أو العرض، ويجب التعامل معه بوصفه عاجلًا لا بندًا مؤجلًا في المحتوى.
هل مؤشر الظهور في الذكاء الاصطناعي هو نفسه درجة SEO؟
لا. فتقييم SEO التقليدي يحسّن لقائمة مرتبة من عشرة روابط. وتقييم الظهور في الذكاء الاصطناعي يحسّن لإجابة مركّبة واحدة، إما أن تُذكر فيها أو لا.
ويتداخل الاثنان في الأساسيات التقنية مثل قابلية الزحف وسرعة الصفحة، ويختلفان بشدة في كل ما عدا ذلك: فعمق المخطط والفقرات على شكل إجابات ووضوح الكيان والتأكيد الخارجي كلها أهم بكثير في الحالة الثانية.
كم مرة يجب أن أعيد الفحص؟
أعد الفحص فورًا بعد تنفيذ دفعة من الإصلاحات لتتمكن من ربط التغيّر في الدرجة بتلك الإصلاحات، ثم شهريًا.
وأعد الفحص أسرع إذا نقلت الموقع، أو غيّرت شبكة توصيل المحتوى أو قاعدة جدار الحماية، أو عدّلت robots.txt، لأن هذه التغييرات أرجح ما يقطع وصول زواحف الذكاء الاصطناعي بصمت.
هل تحتاج الأداة إلى صلاحية الوصول إلى موقعي أو تحليلاتي؟
لا. فهي لا تقرأ إلا الصفحات العامة، بالطريقة نفسها التي يقرأ بها زاحف الذكاء الاصطناعي. فلا وسم للتثبيت، ولا ربط بالتحليلات، ولا يُغيّر أو يُنشر أو يُشارك أي شيء.
أي محركات الذكاء الاصطناعي تأخذها في الحسبان؟
تغطي فحوصات الزواحف وكلاء المستخدم التي يستخدمها ChatGPT وPerplexity وGoogle وغيرها من المحركات الكبرى، وتُطرح أسئلة المشترين على محرك حي متصل بالويب.
وتتوسع تغطية المحركات بمرور الوقت، لذا تعامل مع ركائز الموقع بوصفها الجزء الثابت من القياس، ومع القراءة الحية بوصفها عيّنة حالية.
اقرأ الركائز أولًا والإجمالي ثانيًا
السؤال المفيد ليس ما درجتك، بل أي المجموعات الأربع تحتجز الثلاث الأخرى رهينة، لأن فشل كل منها لا ينفصل عن الأخرى. اقرأ أسطر الركائز الأربع أولًا، وحدد أيها يسبق الأخرى، واقرأ الإجمالي أخيرًا.
فالموقع الذي يحصل على 41 مع حظر GPTBot والموقع الذي يحصل على 41 مع مخطط ضعيف يحتاجان إلى ربعين مختلفين تمامًا من العمل، والرقم المركّب الواحد يخفي هذا الفرق.
لذا هناك مساران من التقرير. فإذا كانت مجموعة الوصول نظيفة ومجموعة البنية ليست كذلك، فالعمل عليك وهو في نطاقك. ويمكنك البدء فيه هذا الأسبوع دون التحدث إلينا.
وإذا كان الوصول يفشل، فلا شيء أسفل القائمة يستحق الجدولة حتى يُحذف ذلك السطر من robots.txt. وإذا كانت المجموعتان نظيفتين ولا تزال لا تُذكر، فقد غادر القيد موقعك، وما تحتاجه بعد ذلك هو التغطية لا تدقيق آخر.
احسب درجتك بنفسك
45 فحصًا، ودليل لكل نتيجة، ودون تسجيل لرؤية الرقم.
اقرأ أيضًا
كل مقالات GEO وAEOChatGPT بين أعلى 7 مواقع في ثلاثة أسواق عربية: بيانات Similarweb وStatCounter لشهر سبتمبر 2026
إلى أي المواقع يوجّه وضع الذكاء الاصطناعي في جوجل بالعربية: 28 سؤالًا وتأثير البلد الذي ينبغي أن تختبره المواقع العربية
GPT-6 صار النموذج الافتراضي في ChatGPT: ما الذي تغيّر في إجابات التسوق لمشتري الخليج ومصر؟ (اختبار قبل وبعد)
llms.txt في المواقع العربية: من ينشره، وماذا يحتوي، وهل تستخدمه مساعدات الذكاء الاصطناعي؟